Resumo
- O Mangaba-Nano-1M tem 1,41 milhão de parâmetros e foi treinado do zero: pesos aleatórios no início, tokenizer próprio, nenhum modelo de terceiros.
- Foram 2,85 bilhões de tokens de texto público em português, em 67 minutos numa NVIDIA L40S.
- No mesmo tamanho e com os mesmos dados, a receita moderna (arquitetura estilo Qwen3, otimizador Muon e agenda WSD) reduz em 10% os bits por byte em relação a um GPT-2 clássico treinado com AdamW, e sobe o acerto no CALAME-PT de 11,7% para 17,1%.
- Ablações mostram que, nessa escala, a forma do modelo quase não importa e a mistura de dados importa pouco. O que mais rende é o otimizador e a arquitetura moderna.
- Na versão 2, com 7,5 vezes mais dados e destilação a partir de um professor de 91M também treinado do zero, o resultado foi misto: melhora fora do domínio e piora no domínio. A v1 continua como versão principal.
- O professor, Mangaba-Base-91M, virou um modelo próprio, com relatório técnico separado: supera o Tucano-160m (1,8× maior) nos dados do nosso domínio e empata no CALAME-PT.
- Por que um modelo minúsculo
- Dados e tokenizer
- Arquitetura
- Receita de treino
- Benchmarks e controles
- Ablações
- GPU compartilhada com produção
- Versão 2: escala e destilação
- Lições
- Como reproduzir
1. Por que um modelo minúsculo
Modelos de bilhões de parâmetros dominam a conversa, mas há um espaço que eles não ocupam: dispositivos sem GPU, navegadores, microcontroladores e tarefas estreitas que precisam responder em microssegundos. Um modelo de 1M de parâmetros cabe em 3 MB e roda a cerca de 1.000 tokens por segundo num notebook comum.
Ele também é um laboratório barato. Cada experimento leva minutos, então dá para fazer o que raramente se faz com modelos grandes: comparar receitas lado a lado, com os mesmos dados e o mesmo orçamento, e medir quanto cada escolha rende de verdade.
Não é um assistente. Com 1M de parâmetros, o modelo aprende ortografia, morfologia e sintaxe do português, e só um pouco de semântica. O texto sai gramatical, mas perde o fio em poucas frases.
2. Dados e tokenizer
Usamos só dados públicos em português, do GigaVerbo-v2:
- Texto da web com nota educacional alta (subconjunto
edu_high): páginas classificadas por um modelo de qualidade educacional. - Texto sintético didático (gigaverbo-v2-synth, Apache-2.0): explicações e exemplos gerados por modelos maiores, em linguagem mais simples.
Na v1, usamos três arquivos de cada fonte: 2,9 bilhões de tokens, sendo 1,02B sintéticos e 1,88B da web. Descartamos documentos com menos de 200 caracteres e normalizamos tudo em Unicode NFC. Antes do treino, separamos 0,5% dos documentos (14 milhões de tokens) para validação; eles nunca entram no treino.
Tokenizer do zero
Num modelo de 1M de parâmetros, o vocabulário é uma decisão de orçamento. Cada token custa uma linha da matriz de embedding: com 4.096 tokens e dimensão 128, só o embedding já consome 524 mil parâmetros, 37% do modelo. Treinamos um BPE byte-level de 4.096 tokens sobre uma amostra de 400 mil documentos do próprio corpus. Ele comprime de 3,4 a 3,7 caracteres por token em português: um pouco menos que vocabulários grandes, mas ainda razoável.
3. Arquitetura
É um decoder no desenho atual da indústria, o mesmo de famílias como Qwen3 e Llama. Usamos a classe Qwen3ForCausalLM do Transformers só como implementação desse desenho: os pesos são inicializados aleatoriamente e nenhum peso da Qwen é usado.
| Componente | Escolha | Por quê |
|---|---|---|
| Camadas × dimensão | 6 × 128, FFN 256 | Venceu as alternativas na ablação (seção 6) |
| Atenção | 4 cabeças de query, 2 de key/value (GQA), head_dim 32 | Menos parâmetros na atenção |
| QK-norm | RMSNorm em query e key | Evita picos de perda |
| Normalização | RMSNorm antes de cada bloco | Treino mais estável |
| Posição | RoPE, θ = 10.000, contexto 512 | Sem tabela de posições para aprender |
| Feed-forward | SwiGLU | Melhor por parâmetro que GELU |
| Embeddings | Amarrados entre entrada e saída | Poupa 524 mil parâmetros |
4. Receita de treino
Otimizador Muon
Nas matrizes internas usamos o Muon: a cada passo, a atualização com momentum de Nesterov é ortogonalizada por 5 iterações de Newton-Schulz, de modo que todas as direções da matriz avançam com a mesma intensidade. Embeddings e normas ficam com o AdamW. Uma varredura curta escolheu a taxa de aprendizado 0,015 para os dois.
Agenda Warmup-Stable-Decay
A taxa sobe por 2% dos passos, fica estável e cai nos últimos 25% numa curva 1−√t. Essa agenda permite parar a qualquer momento: basta fazer o resfriamento a partir do checkpoint estável, sem refazer o treino.
Execução
Usamos precisão mista bf16 e torch.compile. A cross-entropy fica dentro do grafo compilado, então o compilador funde a conversão para float32 com o softmax e não guarda os logits em fp32. Isso reduziu o pico de memória de mais de 680 MB para 326 MB. O lote é de 65.536 tokens por passo, com 43.487 passos e recorte de gradiente em 1,0. A vazão ficou em ~700 mil tokens por segundo.
5. Benchmarks e controles
Não existe outro modelo público de ~1M de parâmetros em português. Para ter uma comparação justa, treinamos dois controles do mesmo tamanho, com os mesmos 2,85B tokens e o mesmo tokenizer, usando a receita clássica (AdamW com agenda cosseno e LR escolhido por varredura):
- mesma arquitetura com AdamW, que isola o efeito do otimizador e da agenda;
- GPT-2 com AdamW (LayerNorm, posição aprendida, GELU, atenção completa, 1,42M de parâmetros), que mostra o efeito somado da arquitetura moderna.
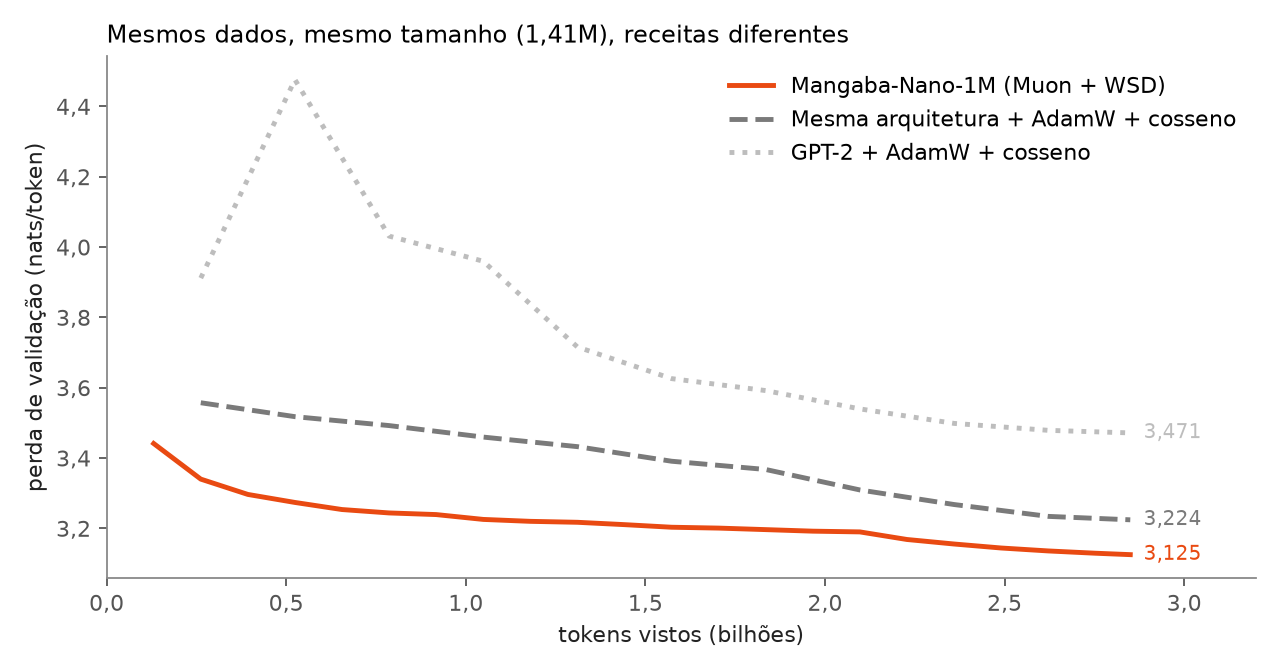
As métricas:
- Bits por byte (BPB): perda medida por byte de texto. Não depende do tokenizer, então compara modelos de vocabulários diferentes. Medimos na validação do GigaVerbo e em 400 artigos da Wikipédia em português (fora do domínio de treino).
- CALAME-PT: 2.076 textos em que o modelo precisa gerar exatamente a última palavra.
- Story Cloze PT: 1.511 histórias em que o modelo escolhe o final certo entre dois. O acaso dá 50%.
| Modelo | Parâmetros | BPB GigaVerbo ↓ | BPB Wikipédia ↓ | CALAME-PT ↑ | Story Cloze ↑ |
|---|---|---|---|---|---|
| Mangaba-Nano-1M | 1,41M | 1,282 | 1,593 | 17,1% | 56,2% |
| Controle: mesma arquitetura + AdamW | 1,41M | 1,323 | 1,635 | 16,2% | 55,9% |
| Controle: GPT-2 + AdamW | 1,42M | 1,425 | 1,736 | 11,7% | 56,7% |
| TinyStories-1M (inglês) | 3,75M | 6,407 | 6,273 | 0,0% | 50,0% |
| Tucano-160m (referência) | 162M | 0,929 | 0,955 | 45,6% | 61,7% |
Decompondo o ganho em bits por byte na validação:
- Arquitetura moderna (de GPT-2 para o desenho atual, ambos com AdamW): de 1,425 para 1,323, −7,2%.
- Muon com WSD (mesma arquitetura): de 1,323 para 1,282, −3,1%.
- Total: −10,0%. No CALAME-PT, de 11,7% para 17,1%.
No Story Cloze os três modelos de ~1M empatam: com 1.511 histórias, a margem de erro é de ±2,5 pontos. Só o Tucano-160m, mais de 100 vezes maior, se destaca. O TinyStories-1M, o modelo público mais próximo em tamanho, foi treinado em inglês e não entende português; entra apenas como referência de porte.
6. Ablações
Com as GPUs dedicadas, rodamos de 10 a 12 treinos de 300M tokens ao mesmo tempo em cada GPU. Todos usam a mesma ordem de amostragem dos dados, para que as diferenças venham só da configuração testada.
Forma: mais fundo ou mais largo?
Trabalhos recentes com modelos de 125M a 1B parâmetros mostram que modelos mais fundos e estreitos rendem mais por parâmetro. Testamos cinco formas com o mesmo orçamento de ~1,4M e duas taxas de aprendizado em cada uma.
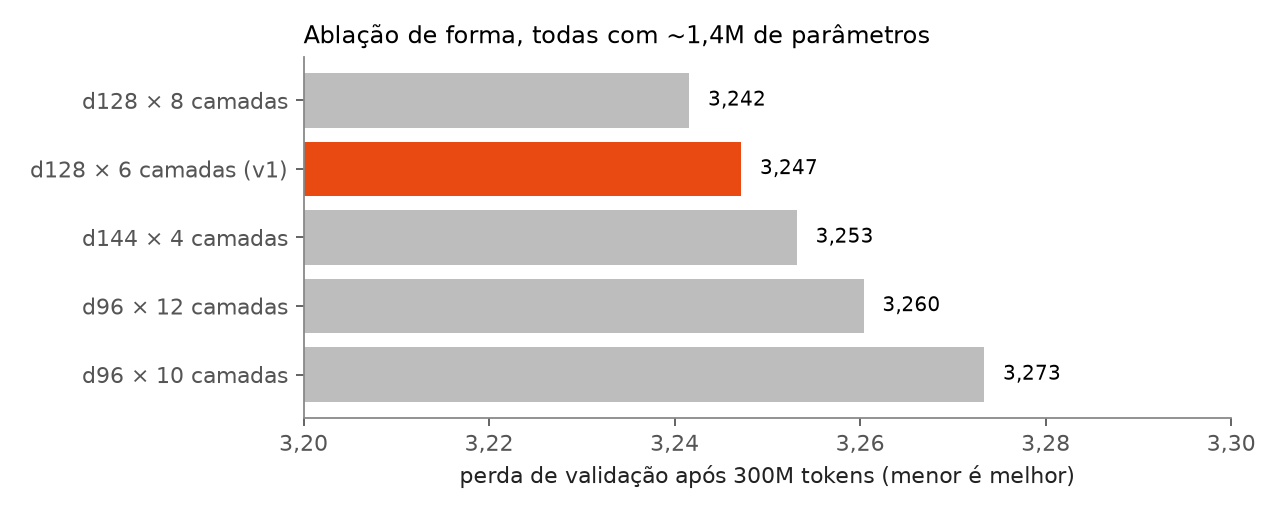
Nessa escala, a forma quase não importa: as cinco ficam a menos de 0,03 de distância. As formas mais fundas e estreitas (d96) perderam, provavelmente porque, com dimensão 96, cada camada fica estreita demais para representar bem o vocabulário. A forma d128 com 8 camadas empata com a da v1, mas é ~35% mais lenta; com o mesmo tempo de GPU, a v1 vê mais tokens. Mantivemos a forma da v1.
Uma sexta forma (d112) foi descartada por desempenho: com head_dim 28, que não é múltiplo de 8, a atenção cai num kernel 4 vezes mais lento.
Mistura de dados
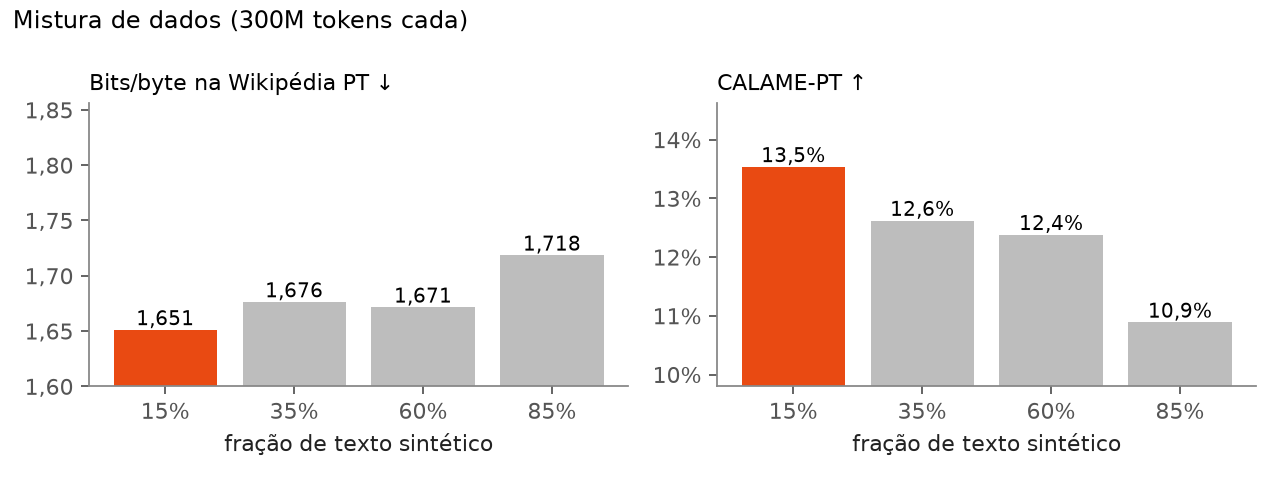
Entre 15% e 60% de texto sintético, a perda na validação empata. Mas menos sintético é melhor fora do domínio: Wikipédia e CALAME preferem 15%. Com 85%, tudo piora. Texto sintético simplificado ajuda modelos minúsculos até certo ponto; depois, falta variedade.
7. GPU compartilhada com produção
As duas L40S deste projeto, num datacenter no Brasil, também servem um modelo de 122B de parâmetros em produção, que reserva 95% da memória de cada GPU. A v1 foi treinada nos ~2,5 GB que sobravam. Um teto de memória por processo (set_per_process_memory_fraction) garante que o treino nunca invada a reserva do modelo de produção.
Memória não foi o problema; computação foi. Medindo direito, com o treino pausado e retomado no mesmo minuto, um único treino ao lado do modelo de produção aumentou o tempo de resposta de 2,6 s para 4,5 s; dois treinos, para 7,2 s. Como o modelo de produção divide as duas GPUs, qualquer carga extra em uma delas atrasa tudo. Nossa primeira medição tinha indicado "sem impacto", mas pausava o processo errado.
A solução foi uma janela noturna dedicada: o modelo de produção é desligado, o tráfego vai para um modelo reserva em CPU, e as GPUs ficam 100% para treino até de manhã. A v1 usou menos de 2% de uma GPU (~6 TFLOPS); a v2 usa as duas a 98–100%.
8. Versão 2: escala e destilação
A v2 manteve a arquitetura e mudou três coisas:
- Mais dados: mais 20 arquivos do
edu_highe mais 12 do sintético. O total passou de 2,9B para 21,6B tokens, com ~24% de sintético, a proporção natural dos dados e dentro da faixa que funcionou na ablação. - Um professor treinado do zero: o Mangaba-Base-91M (dimensão 768, 14 camadas, 91,25M de parâmetros, mesmo tokenizer), treinado em 2,52B tokens em 4h52 numa L40S. Ele também começou de pesos aleatórios.
- Destilação de logits: o aluno de 1,4M aprende a distribuição completa de probabilidades do professor para o próximo token. A perda combina 30% de cross-entropy com 70% de divergência KL. Em 4 horas, o aluno viu 4,9B tokens a 345 mil tokens/s; a maior parte do custo é o professor.
Para medir o efeito da destilação, um controle sem professor rodou ao mesmo tempo na outra GPU por ~8 horas (33,8B tokens).

| Modelo | Tokens | BPB GigaVerbo ↓ | BPB Wikipédia ↓ | CALAME-PT ↑ | Story Cloze ↑ |
|---|---|---|---|---|---|
| Nano-1M v1 | 2,85B | 1,282 | 1,593 | 17,1% | 56,2% |
| Nano-1M v2 destilado | 4,9B | 1,296 | 1,569 | 17,8% | 55,4% |
| Nano-1M v2 controle (instabilizou) | 33,8B | 1,370 | 1,674 | 11,8% | 58,0% |
| Mangaba-Base-91M (professor) | 2,5B | 0,886 | 1,091 | 45,7% | 57,8% |
| Tucano-160m (referência) | — | 0,929 | 0,955 | 45,6% | 61,7% |
O que os números dizem
- A destilação deu um resultado misto. Fora do domínio, o destilado melhora: −1,5% de bits por byte na Wikipédia, e +0,7 ponto no CALAME, dentro da margem de erro de ±1,6. Na validação do domínio, piora 1,1%. Pelo critério que fixamos antes de ver os resultados (só promover a v2 se ela superasse a v1), a v1 continua no
main, e a v2 fica no branchv2-destilado. - A validação favorece a v1. Ela foi separada dos mesmos arquivos em que a v1 treinou (35% de texto sintético), enquanto a v2 treinou com 24% e com outros arquivos. Parte da piora no domínio vem dessa diferença de distribuição; as métricas fora do domínio são a comparação mais justa.
- A distância entre professor e aluno é grande. O professor tem 65 vezes mais parâmetros. A literatura de destilação descreve uma "lacuna de capacidade": quando o professor é muito maior, o aluno não consegue imitar sua distribuição e o ganho cai. Um professor intermediário (5–20M) pode render mais.
- O controle não é uma comparação justa. Ele instabilizou no meio do treino (próxima seção). Mesmo antes disso, o aquecimento de 2% de um treino muito longo durou 0,67B tokens, e ele ficou atrás da v1 desde o início.
- O professor é o resultado mais forte da noite. Com 2,5B tokens, ele supera o Tucano-160m na validação do domínio (0,886 contra 0,929) e empata no CALAME-PT (45,7% contra 45,6%). Na Wikipédia e no Story Cloze fica atrás, o que é esperado com menos tokens e menos variedade de fontes. Os detalhes estão no relatório do Base-91M.
9. Lições
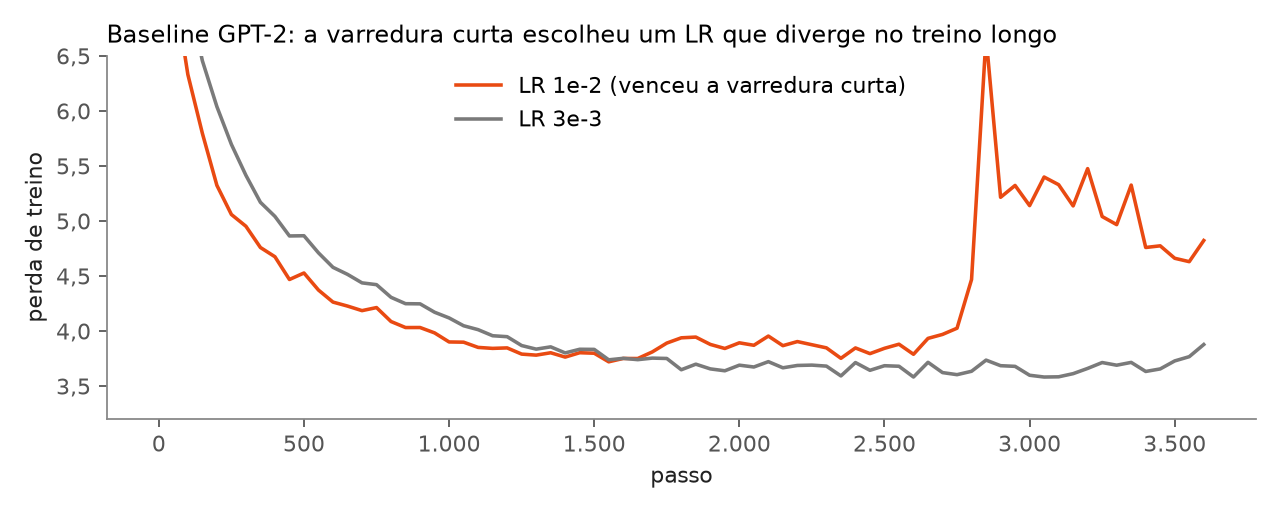
- Varreduras curtas de LR enganam. No controle GPT-2, a taxa 1e-2 venceu em 40M tokens e divergiu no passo ~2.900 do treino longo. Escolher a taxa vencedora da varredura curta e abaixá-la um pouco é mais seguro.
- Tokenize contexto e resposta juntos na avaliação. Nossa primeira medição do CALAME-PT deu 0% ao Tucano-160m. Tokenizers SentencePiece tratam o espaço inicial de
" palavra"de forma diferente quando a palavra aparece sozinha. Tokenizando o texto completo e recortando a resposta, o resultado correto é 45,6%. - Use head_dim múltiplo de 8. Caso contrário, a atenção cai num kernel lento, e o custo pode superar qualquer ganho da forma.
- Meça o impacto na produção pausando o processo certo. Em comandos remotos,
pgrep -fcasa com o próprio shell que o executa. - Em treino longo, o Muon precisa de weight decay. O controle da v2 usou a receita da v1 sem weight decay. Ela era estável em 2,85B tokens, mas instabilizou depois de ~8B, com a perda subindo e ficando presa por 15B tokens. Trabalhos que usam o Muon em escala (Moonlight) adicionam weight decay justamente para conter o crescimento dos pesos. Treinos curtos não revelam esse problema.
- Aquecimento proporcional engana em treinos longos. 2% de warmup é razoável em 3B tokens, mas vira 0,67B tokens num treino de 34B. É melhor fixar o aquecimento em passos ou tokens absolutos.
- Fixe o critério de sucesso antes de ver os números. Combinamos que a v2 só substituiria a v1 se fosse melhor. O resultado misto, então, não é publicado como "melhoria".
- Em 1M de parâmetros, o embedding é o maior bloco. Com vocabulário de 4.096, ele ocupa 37% do modelo. Testar vocabulários de 2.048 e 8.192 é o próximo experimento óbvio.
10. Como reproduzir
Tudo está no repositório do modelo: prep.py (tokenizer e tokenização), train.py (treino da v1 e dos controles), bench.py (a suíte de benchmarks), eval_bpb.py e make_card.py. A v2 usa train2.py (dados em vários arquivos, mistura configurável, orçamento por relógio e destilação). O professor está em mangaba-ai/Mangaba-Base-91M e tem relatório próprio.
from transformers import AutoModelForCausalLM, AutoTokenizer
tok = AutoTokenizer.from_pretrained("mangaba-ai/Mangaba-Nano-1M")
model = AutoModelForCausalLM.from_pretrained("mangaba-ai/Mangaba-Nano-1M")
ids = tok("A fotossíntese é o processo", return_tensors="pt").input_ids
print(tok.decode(model.generate(ids, max_new_tokens=60, do_sample=True, temperature=0.7)[0]))
Com o llama.cpp: llama-completion -m Mangaba-Nano-1M-F16.gguf -p "O Brasil é um país" -n 60.
Limitações
- O texto é gramatical, mas sem coerência além de poucas frases, e inventa fatos. Não use para responder perguntas.
- Não há ajuste de instrução nem alinhamento. O contexto máximo é de 512 tokens.
- O modelo herda os vieses do texto da web em português.
- Cada ablação usou uma única seed. Diferenças menores que ~0,01 de perda devem ser lidas como empate.